Die entscheidende Frage in modernen Unternehmen lautet längst nicht mehr, ob künstliche Intelligenz Aufgaben autonom erledigen kann. Die eigentliche betriebswirtschaftliche und haftungsrechtliche Kernfrage lautet: Wer kontrolliert eigentlich, ob die KI-Agenten ihre Arbeit fehlerfrei, gesetzeskonform und im Sinne der Unternehmensrichtlinien ausführen?
Verlassen sich Unternehmen auf unkontrollierte Einzelagenten, drohen unbemerkte Fehlbuchungen, fehlerhafte Vertragsklauseln oder peinliche Kundenreklamationen. Menschliche Kontrollen für jede einzelne Transaktion skalieren jedoch nicht – sie würden den gesamten Geschwindigkeitsvorteil der Automatisierung zunichtemachen. Ein praxiserprobtes Architekturprinzip kann eine gute Lösung liefern: KI-Agenten kontrollieren KI-Agenten (Peer Review Architecture). Kein Agent agiert ohne unabhängiges Korrektiv. Jede geschäftskritische Ausgabe wird mehrstufig verifiziert, bevor sie Produktivsysteme erreicht. Wie dieser Qualitätskontroll-Workflow aufgebaut ist und warum er die Fehlerquote in Prozessen um über 95 Prozent senkt, erläutert dieser Fachbeitrag.
Das Risiko blinder Autonomie im Geschäftsbetrieb
Jedes KI-System – ganz gleich, wie leistungsfähig das zugrunde liegende Modell ist – besitzt eine prinzipbedingte stochastische Natur. Sprachmodelle berechnen Wahrscheinlichkeiten von Wortfolgen. Sie „wissen“ im menschlichen Sinne nichts über die Konsequenzen einer fehlerhaften Zahlungsfreigabe oder eines falsch interpretierten Kündigungsdatums.
Das eigentliche Problem im Unternehmensalltag ist nicht der einzelne Fehler an sich, sondern das unbemerkte Fortpflanzen von Fehlern in automatisierten Hochgeschwindigkeitsprozessen. Wenn ein Agent 500 Eingangsrechnungen pro Stunde verarbeitet und dabei bei 2 Prozent der Belege die Vorsteuer falsch berechnet oder Skontofristen übergeht, summiert sich dieser Schaden innerhalb weniger Tage zu empfindlichen Finanzverlusten und steuerrechtlichen Sanktionen. Die traditionelle Annahme „Die KI wird das schon richtig machen“ ist im professionellen Mittelstand schlicht fahrlässig.
Das Prinzip: Kontrolle durch Peers (Actor-Critic-Architektur)
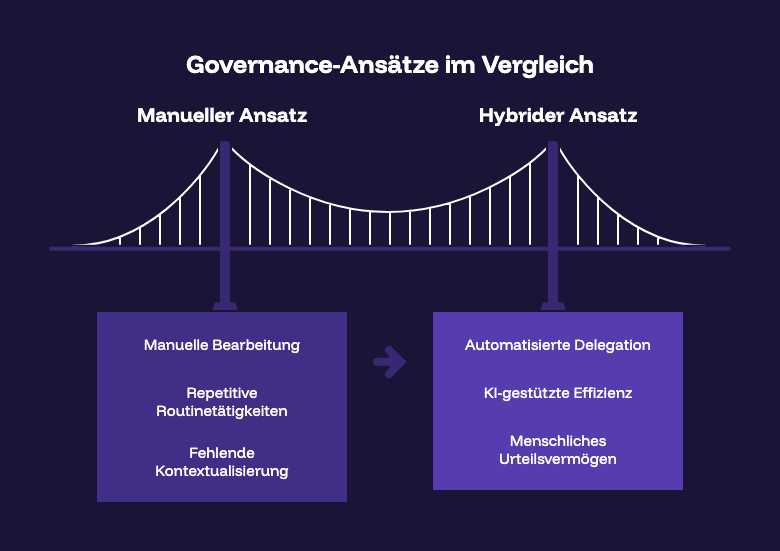
Die klassische Lösung zur Qualitätssicherung besteht darin, einen menschlichen Mitarbeiter jeden einzelnen Schritt gegenlesen zu lassen (Human-in-the-Loop). In der Realität führt das jedoch schnell zu einem massiven Engpass: Wenn ein System 2.000 Kundenvorgänge am Tag abwickelt, ermüden menschliche Prüfer nach wenigen Stunden. Die Aufmerksamkeit sinkt, Routinefehler werden übersehen, und die Personalkosten steigen enorm.
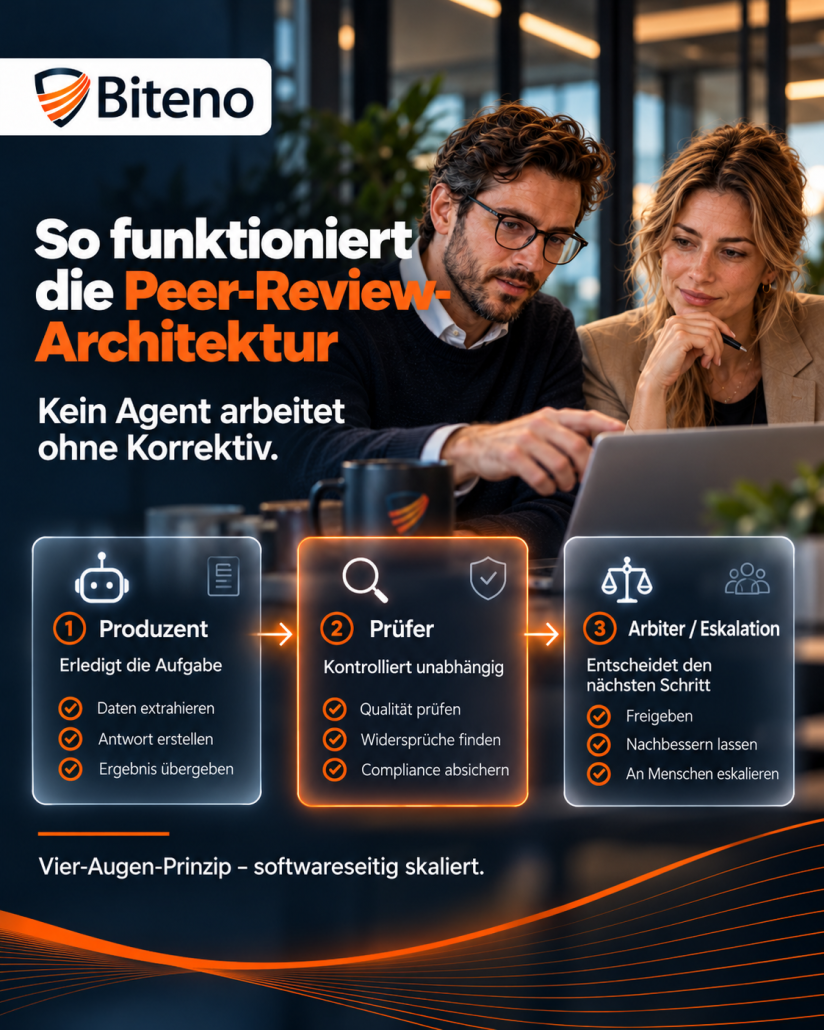
Unsere Antwort ist die softwareseitige Institutionalisierung des Vier-Augen-Prinzips durch getrennte Rollen:
- Der Produzent (Actor / Generator): Er erledigt die operative Primäraufgabe – er extrahiert Daten, kalkuliert Angebote, vergleicht Vertragsentwürfe oder verfasst Kundenantworten.
- Der Prüfer (Critic / Reviewer): Ein vollkommen unabhängiger Agent, der nicht am Erstellungsprozess beteiligt war. Er erhält die Rohdaten, das Arbeitsergebnis des Produzenten und einen strikten Katalog deterministischer sowie semantischer Prüfkriterien.
- Der Arbiter / Eskalations-Router: Bei Uneinigkeit oder Grenzwerten entscheidet dieser Knoten, ob eine automatische Nachbesserungsschleife initiiert wird oder ob der Fall zur finalen Freigabe auf dem Schreibtisch eines menschlichen Experten landet.
Die 3-Schichten-Architektur robuster Qualitätskontrolle
Um ein solches Prüfnetzwerk im Unternehmen stabil zu verankern, kombiniert man drei komplementäre Prüfschichten, die von einfachen Rechenregeln bis hin zu komplexem semantischem Verstehen reichen:
Schicht 1: Deterministische Validierungsregeln (Hartes Regelwerk)
Bevor überhaupt ein zweites Sprachmodell bemüht wird, durchläuft jedes Ergebnis eine automatisierte Code-Validierung:
- Mathematische Konsistenz: Stimmt die Summe der Einzelpositionen exakt mit dem Rechnungs-Gesamtbetrag überein? Ergibt Einzelpreis mal Menge exakt den Zeilenpreis?
- Format- und Typvalidierung: Entspricht die IBAN der ISO-Norm? Liegt das Rechnungsdatum in der Vergangenheit und nicht im Jahr 2099? Ist die Steuernummer syntaktisch valide?
- Referenzprüfungen in Primärsystemen: Existiert die genannte Bestellnummer im ERP? Ist die hinterlegte Kundennummer aktiv?
Diese Schicht benötigt keine KI, verbraucht null Tokens und filtert in Millisekunden über 60 % aller offensichtlichen Flüchtigkeitsfehler zuverlässig heraus.
Schicht 2: Semantische KI-Peer-Review (Kontextuelles Verstehen)
Ergebnisse, die Schicht 1 fehlerfrei passieren, werden dem Review-Agenten vorgelegt. Er analysiert Aspekte, die sich nicht in starre Programmierregeln fassen lassen:
- Inhaltliche Vollständigkeit: Wurden alle vom Kunden in der E-Mail aufgeworfenen Fragen beantwortet oder wurde eine kritische Teilfrage übersehen?
- Widerspruchsfreiheit: Steht die Kündigungsfrist im Angebotstext im Einklang mit den AGB im Anhang?
- Tonalität und Compliance: Entspricht der Tonfall den Kommunikationsrichtlinien des Hauses? Wurden versehentlich sensible interne Daten oder nicht freigegebene Rabattversprechen formuliert?
- Plausibilität gegen historische Benchmarks: Liegt der berechnete Stundensatz oder Projektumfang im normalen statistischen Rahmen dieses Kundensegments?
Schicht 3: Risiko-basierter Human-in-the-Loop
Nicht jeder Vorgang muss von Menschen gesehen werden, aber kritische Vorgänge dürfen niemals vollautonom durchlaufen. Die Peer-Review-Architektur definiert messbare Schwellenwerte für die menschliche Intervention:
- Monetäre Schwellen: Rechnungsfreigaben über 5.000 Euro oder Rabatte über 10 % erfordern zwingend den Klick eines autorisierten Abteilungsleiters.
- Konfidenz-Grenzwerte: Liegt die statistische Sicherheit des Prüf-Agenten unter 95 %, wird der Fall als „Grauzone“ markiert und dem Sachbearbeiter mit farblicher Hervorhebung der unsicheren Textstelle vorgelegt.
- Zufällige Qualitätsstichproben: 2 bis 5 % aller vollautomatisch genehmigten Standardvorgänge werden stichprobenartig für menschliche Audits ausgesteuert, um die Qualität der Prüf-Agenten kontinuierlich zu überwachen.
Praxis-Fallstudie: Rechnungsprüfung bei einem Baudienstleister
- Erfassungsagent: Liest Rechnungsdaten wie Beträge, Steuersätze, Skonto und Sicherheitseinbehalte aus.
- Validierungsagent: Gleicht Lieferanten-, Projekt- und Vertragsdaten mit den Stammdaten ab.
- Fachagent: Prüft bauspezifische Regeln wie VOB-Einbehalte, Nachlässe und Bauabzugssteuer.
- Kontrollagent: Prüft die Ergebnisse der anderen Agenten unabhängig auf Abweichungen und Widersprüche.
- Freigabe: Nur konsistente Rechnungen werden automatisch weiterverarbeitet; Auffälligkeiten gehen in die manuelle Prüfung.
- Dokumentation: Jeder Prüfschritt wird automatisch in einem strukturierten JSON-Protokoll festgehalten.
Praxis-Fallstudie 2: Reputationsschutz im B2B-Kundensupport
Qualitätskontrolle ist nicht nur bei Rechnungen und Zahlen erfolgskritisch, sondern vor allem in der externen Kundenkommunikation. Ein Software-Hersteller für Logistiklösungen stand vor der Herausforderung, dass sein First-Level-Support mit über 800 technischen Kundenanfragen pro Tag überlastet war. Ein zuvor getesteter autonomer Standard-Chatbot führte zu massiven Beschwerden: Das System erfand im Dialog technische Produktmerkmale, die erst für das Folgejahr geplant waren, und versprach Kunden kostenlose Software-Updates, die vertraglich kostenpflichtig waren.
Die 2-stufige Review-Architektur
Wir führten ein streng getrenntes Produzenten-Prüfer-System ein:
- Der Antwort-Generator (Produzent): Er analysiert das Ticket, sucht in der internen Confluence-Dokumentation nach der technischen Lösung und formuliert einen verständlichen Antwortentwurf an den Kunden.
- Der Compliance- & Feature-Prüfer (Reviewer): Dieser Agent gleicht jeden einzelnen Satz des Entwurfs gegen die offizielle Produktspezifikation und die AGB ab. Er stellt vier harte Prüffragen:
- Werden Funktionen als verfügbar beschrieben, die in der aktuellen Versionsnummer noch nicht freigegeben sind?
- Werden verbindliche Fristen, finanzielle Zugeständnisse oder SLAs garantiert, die die Autorisierungsgrenze überschreiten?
- Enthält der Text versehentlich Kundendaten anderer Mandanten oder interne Notizen?
- Wurden alle vom Kunden genannten Fehlercodes vollständig adressiert?
Wird eine Diskrepanz festgestellt, blockiert der Prüfer den Versand und schickt den Entwurf mit einer exakten Fehlernotiz zurück an den Produzenten zur Überarbeitung. Erst nach dem „PASS“-Signal des Prüfers wird die Nachricht per E-Mail an den Kunden versendet.
Messbare Resultate der Support-Automatisierung
Nach drei Monaten im Produktivbetrieb sanken die Kundenreklamationen wegen Falschauskünften auf null. Gleichzeitig sank die durchschnittliche Beantwortungszeit für Standardanfragen von 4,5 Stunden auf unter 90 Sekunden. Der Supportleiter des Softwarehauses fasste das Ergebnis treffend zusammen: „Die Qualitätskontrolle durch den zweiten Agenten hat uns den Schlaf zurückgegeben. Wir können das System nachts und am Wochenende vollkommen beruhigt alleine arbeiten lassen.“
Technische Architektur: Der geschlossene Korrektur-Kreislauf
Ein funktionierendes Peer-Review-System darf nicht als lineare Kette enden, sondern muss einen geschlossenen Regelkreis (Closed Loop) abbilden. Wenn der Prüfer einen Mangel identifiziert, muss das System den Fehler autonom beheben können, ohne sofort menschliche Ressourcen zu binden.
Denkbar ist eine strukturierte Zustandsmaschine mit klar definierten Fehlerklassen:
- Klasse A (Syntaktischer Fehler): Fehlendes Datumsfeld, falsches Währungsformat. Der Prüfer übermittelt das fehlende Pflichtfeld, und der Produzent korrigiert den Datensatz in Millisekunden autonom.
- Klasse B (Logischer Widerspruch / Lücke): Eine Aussage im Text passt nicht zu den Daten der Wissensdatenbank. Der Prüfer weist auf den konkreten Widerspruch hin. Der Produzent erhält maximal zwei Überarbeitungsversuche (Self-Correction Loop).
- Klasse C (Kritische Abweichung / Compliance-Bruch): Unstimmigkeiten bei Summen über der Freigabegrenze oder potenziell justiziable Aussagen. Hier wird die automatische Verarbeitung sofort gestoppt. Der Vorgang landet im Eskalations-Dashboard des zuständigen Mitarbeiters.
Jede dieser Korrekturschleifen wird in einer persistenten Datenbank auditiert. Aus den gesammelten Review-Ergebnissen destilliert unser System wöchentlich statistische Reports: Welche Fehlermuster traten am häufigsten auf? Welche Prompts des Produzenten müssen nachgeschärft werden? Auf diese Weise wird das gesamte System von Woche zu Woche treffsicherer.
Auditierbarkeit für Wirtschaftsprüfer und ISO 27001
In regulierten Branchen (Finanzwesen, Gesundheitssektor, produzierendes Gewerbe mit NIS-2- oder ISO-Zertifizierung) ist nicht nur die Richtigkeit einer Entscheidung wichtig, sondern deren lückenlose Nachweisbarkeit. Wirtschaftsprüfer fordern heute zunehmend den Nachweis, wie automatisierte Algorithmen überwacht werden.
Ein einfaches Modell, das unprotokolliert im Hintergrund agiert, stellt bei jedem Audit ein gravierendes Risiko dar. Die Peer-Review-Architektur von Biteno liefert hingegen für jeden Geschäftsvorfall ein revisionssicheres Kontrollzertifikat:
- Welches Rohdokument ging um wie viel Uhr ein?
- Welcher Agent hat welche Daten extrahiert?
- Welche mathematischen und logischen Prüfungen hat der Reviewer durchgeführt?
- Welche Konfidenzwerte und Kriterien führten zur automatischen Freigabe oder zur manuellen Eskalation?
- Wer hat die finale Zeichnung vorgenommen?
Mit diesem Prüfprotokoll erfüllen Unternehmen selbst die strengsten Anforderungen von Wirtschaftsprüfern und Aufsichtsbehörden mit Leichtigkeit.
Wer kontrolliert den Kontrolleur? (Meta-Auditing)
Eine berechtigte Frage von Vorständen und Wirtschaftsprüfern lautet: „Was passiert, wenn der Prüf-Agent selbst Fehler macht oder halluziniert?“
Um ein Versagen der Kontrollinstanz auszuschließen, etablieren wir ein zweistufiges Meta-Auditing:
1. Asymmetrische Modell-Diversität
Produzent und Prüfer laufen niemals auf derselben Modellfamilie oder mit identischen System-Prompts. Wenn der Produzent auf einem Open-Source-Modell basiert, lassen wir den Prüfer auf einem führenden Frontier-Reasoning-Modell laufen (oder umgekehrt). Dadurch wird verhindert, dass systematische Blindheiten eines bestimmten Algorithmus unbemerkt durchgewunken werden.
2. Kontinuierliches Kalibrierungs-Monitoring
Unser Tracing-System überwacht fortlaufend die statistische Ablehnungsquote des Prüfers. Fällt die Beanstandungsrate eines Prüf-Agenten plötzlich von den gewohnten 4,2 % auf 0,1 %, schlägt das System Alarm: Es liegt der Verdacht nahe, dass ein Prompt-Update oder ein API-Versionswechsel den Prüfer „zu nachsichtig“ gemacht hat. Das System stoppt automatisch die Dunkelverarbeitung und erzwingt manuelle Reviews, bis die Kalibrierung wiederhergestellt ist.
Schritt-für-Schritt: Qualitätskontrolle in Workflows im eigenen Unternehmen aufbauen
Für die Einführung einer verlässlichen Peer-Review-Architektur empfiehlt sich ein strukturierter Vierschritt:
Schritt 1: Definition des „Gold-Standards“
Legen Sie schriftlich fest, wie ein perfektes Arbeitsergebnis für den Zielprozess aussieht. Sammeln Sie mindestens 50 historische Beispielfälle inklusive typischer Fehlerquellen (Grenzfälle, Falschbuchungen, Reklamationen). Diese Fälle dienen als Test-Suite zur Validierung des Prüf-Agenten.
Schritt 2: Implementierung der harten Regeln (Schicht 1)
Automatisieren Sie alle mathematischen, syntaktischen und referenziellen Prüfungen im Code. Je mehr Fehler Sie deterministisch abfangen, desto günstiger und schneller läuft das Gesamtsystem.
Schritt 3: Aufsetzen des unabhängigen Review-Prompts (Schicht 2)
Instruieren Sie den Prüf-Agenten mit einem explizit kritischen Mindset. Seine Erfolgsmetrik ist nicht Geschwindigkeit, sondern das zielsichere Aufspüren von Diskrepanzen, Auslassungen und Risiken.
Schritt 4: Festlegung klarer Eskalationspfade (Schicht 3)
Definieren Sie exakt, bei welchen Beträgen, Risikoklassen oder Konfidenzwerten der Prozess an einen Menschen eskaliert werden muss. Schaffen Sie intuitive Freigabe-Oberflächen, in denen der Prüfer dem Menschen das gefundene Problem in zwei Sätzen verständlich erklärt.
Durch die Etablierung algorithmischer Peer-Reviews schaffen Unternehmen die notwendige Vertrauensbasis für die nächste Stufe der Digitalisierung. Wenn Qualität nicht mehr vom Zufall abhängt, sondern systemisch garantiert wird, verwandelt sich künstliche Intelligenz von einem riskanten Experiment in einen verlässlichen Wettbewerbsvorteil, der Tag und Nacht messbaren Mehrwert erwirtschaftet.
Unternehmen, die frühzeitig auf strukturierte Review-Pipelines setzen, vermeiden nicht nur teure Reputationsschäden, sondern beschleunigen gleichzeitig ihre internen Freigabeprozesse um ein Vielfaches. Es entsteht eine skalierbare operative Exzellenz, die menschliche Fachkräfte entlastet und dem Management ruhigen Schlaf garantiert.
Zusammenfassend lässt sich festhalten: Intelligente Automatisierung erfordert intelligente Qualitätssicherung. Wer Agenten ohne unabhängige Kontrolle einsetzt, riskiert unnötige Rückschläge. Wer hingegen Peers zur Verifikation etabliert, baut das Fundament für nachhaltigen Erfolg.
Fazit: Vertrauen ist gut, algorithmische Kontrolle ist besser
Autonome KI-Agenten entfalten ihre gewaltige Produktivitätswirkung erst dann, wenn das Management ihnen uneingeschränkt vertrauen kann. Dieses Vertrauen entsteht nicht durch blindes Hoffen, sondern durch eine kompromisslose Architektur gegenseitiger Kontrolle.
Indem wir das Prinzip der Peer-Review fest in unsere Automatisierungs-Pipelines einbauen, vereinen wir das Beste aus zwei Welten: Die unübertroffene Geschwindigkeit und Skalierbarkeit von Algorithmen mit der Zuverlässigkeit und Regeltreue, die im professionellen Geschäftsbetrieb unverzichtbar sind. Das ist moderne, risikofreie Prozessautomatisierung.
Möchten Sie erfahren, wie Sie automatisierte Qualitätskontrollen in Ihre bestehenden KI-Workflows integrieren?
Buchen Sie jetzt ein unverbindliches Sparring-Gespräch mit den Experten von Biteno
Weiterführende Fachbeiträge & Ressourcen: