
In modernen Unternehmensprozessen wächst der Druck, wiederkehrende Aufgaben wie die Klassifizierung von Kundenanfragen, das Routing von Support-Tickets oder die Überprüfung von Eingangsdaten vollautomatisch abzuwickeln. Viele IT-Entscheider setzen dabei zunächst auf bekannte generative Sprachmodelle wie ChatGPT, Claude oder Llama. In der Praxis führt dieser Ansatz jedoch häufig zu Frustration: Generative Large Language Models (LLMs) sind für einfache Ja/Nein-Entscheidungen oder Kategorisierungen oft viel zu langsam, erzeugen spürbare API-Kosten und neigen bei strukturierten JSON-Ausgaben zu Syntaxfehlern.
Genau hier vollzieht sich derzeit ein fundamentaler Paradigmenwechsel in der KI-Entwicklung: der Aufstieg spezialisierter „System 1 Modelle“. Nach dem proprietären Modell Jev von TypeSafe AI steht mit Laya nun eine leistungsstarke, transparente Open-Source-Alternative (unter Apache-2.0-Lizenz) bereit, die es Unternehmen erlaubt, blitzschnelle und deterministische Entscheidungen direkt auf der eigenen Infrastruktur zu treffen.
In diesem Beitrag erfahren Sie, wie das Modell Laya architektonisch aufgebaut ist, welche weiteren Open-Source-Alternativen existieren und wie Sie solche schlanken Entscheidungsmodelle gewinnbringend in Ihre IT- und Workflow-Pipelines integrieren.
Was ist Laya? Das Prinzip der typensicheren Nicht-Chat-Entscheidung
Um Laya zu verstehen, hilft die Unterscheidung der Kognitionspsychologie nach Daniel Kahneman („Schnelles Denken, langsames Denken“):
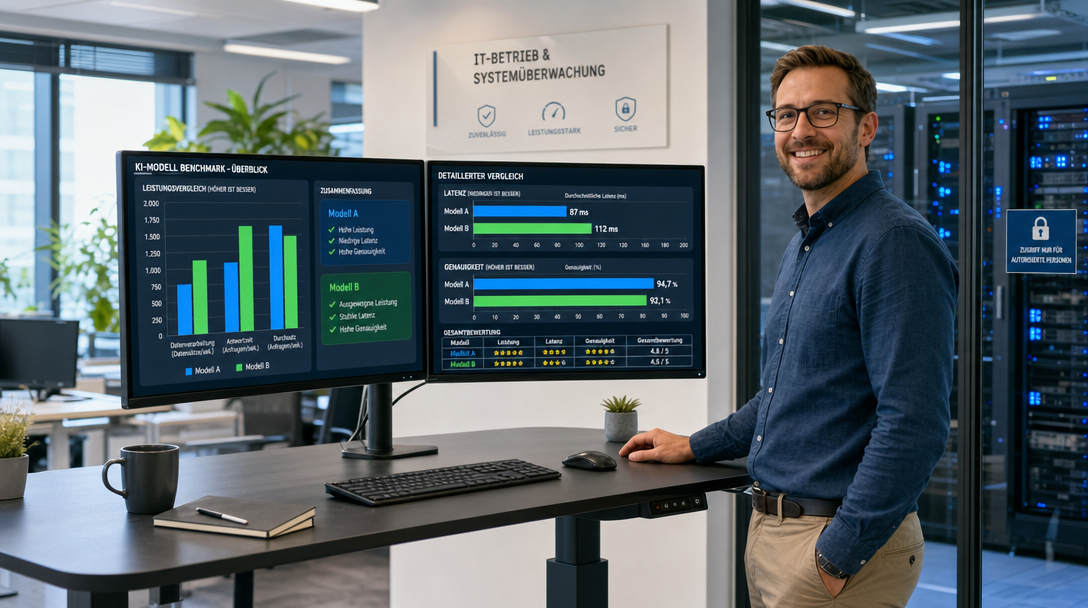
- System 2 (Generative Chat-LLMs): Denkt langsam, formuliert Token für Token, begründet ausführlich und benötigt erhebliche Rechenzeit (typischerweise 1.500 bis 5.000 Millisekunden).
- System 1 (Laya): Trifft unmittelbare, intuitive und mathematisch exakt abgewogene Entscheidungen auf Basis gelernter Muster – in einem einzigen Durchlauf (Forward Pass) in lediglich 30 bis 200 Millisekunden.
Das Besondere an Laya: Das Modell generiert keinen Text.
Anstatt Fließtext zu verfassen, nimmt Laya einen Zustand (State – etwa den Text einer Kunden-E-Mail, ein Ticket, eine Servermeldung oder ein JSON-Objekt) entgegen und beantwortet dazu vordefinierte, typisierte Fragen. Das Modell liefert garantiert strukturiertes JSON zurück, ohne dass reguläre Ausdrücke oder fehleranfälliges Parsen erforderlich sind.
Die drei Fragetypen von Laya
Entwickler und Automatisierer können Laya drei präzise Abfragetypen übergeben:
- Choice (Klassifikation): Zuordnung zu einer von bis zu 255 vordefinierten Klassen inklusive exakter Wahrscheinlichkeitsverteilung (z. B. Abteilung: Billing, Support, Vertrieb).
- Score (Skalierung): Bewertung auf einer diskreten Skala (z. B. Dringlichkeitsstufe von 0 bis 5 oder Eskalationsgrad).
- Noul (Boolean / Wahrheitswert): Eindeutige Ja/Nein-Entscheidungen mit kalibrierter Wahrscheinlichkeit (z. B.
1is_spam: true
oder
1requires_human_review: false).
Werden mehrere Fragen an ein Dokument gestellt, evaluiert Laya alle Kriterien parallel in einem einzigen Durchlauf.
Architektur, RLCD-Training und Kontextfenster
Laya wurde von Convai Innovations entwickelt und steht auf Hugging Face in spezialisierten Checkpoints zur Verfügung:
- laya-multilingual (mmBERT-base): Mit nur 322 Millionen Parametern deckt dieses Modell über 100 Sprachen – darunter hervorragend Deutsch – ab. Es verarbeitet standardmäßig 1.024 Tokens und lässt sich für längere Geschäftsdokumente auf bis zu 8.192 Tokens erweitern.
- laya (ModernBERT-large): Mit 421 Millionen Parametern optimiert für hochpräzise englischsprachige Klassifikationsaufgaben auf Basis modernster BERT-Architektur.
- laya-typed-decisions: Spezialisiert auf komplexe Decision-Graphs und Routing-Workflows in Agenten-Systemen.
Mathematisch kalibrierte Wahrscheinlichkeiten durch RLCD
Ein gravierendes Problem klassischer Sprachmodelle sind Halluzinationen und übersteigertes Selbstvertrauen: Ein LLM behauptet oft mit 100 % Überzeugung etwas, das schlicht falsch ist.
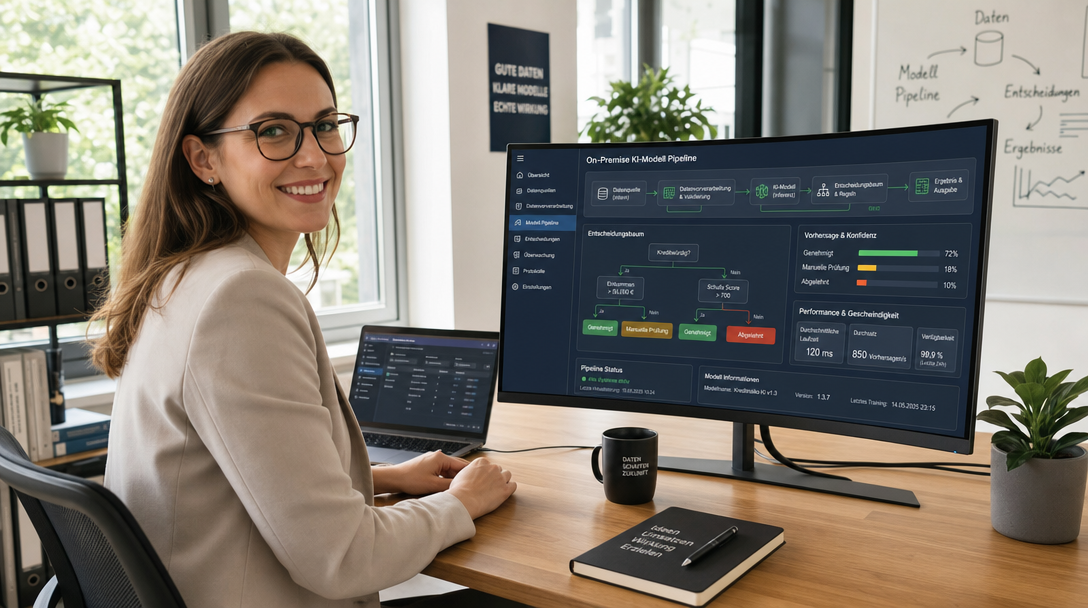
Laya wurde mittels RLCD (Reinforcement Learning from Calibrated Decisions) trainiert. Dabei wird das Modell gegen mathematisch strikte Bewertungsregeln (Proper Scoring Rules) belohnt. Die Konsequenz: Das Modell maximiert seinen Reward ausschließlich dann, wenn die ausgegebenen Konfidenzwerte den tatsächlichen statistischen Wahrscheinlichkeiten entsprechen. Ein Konfidenzwert von 85 % bedeutet in der Praxis auch verlässlich eine 85-prozentige Trefferwahrscheinlichkeit.
Open-Source-Alternativen: Welche Modelle gibt es sonst in dieser Kategorie?
Laya ist ein Vorreiter für spezialisierte Nicht-Chat-System-1-Modelle – doch ist es das einzige Modell in der Open-Source-Welt? Die Antwort lautet: Nein, aber es besetzt eine sehr spezifische Nische.
Um die passende Technologie für Ihr Unternehmen auszuwählen, lohnt ein Blick auf die unterschiedlichen Architekturansätze im Open-Source-Bereich:
1. Spezialisierte RLCD- und System-1-Entscheidungsmodelle
Neben Laya formiert sich auf Hugging Face eine neue Modellklasse, die direkt auf RLCD und strukturierte Typenentscheidungen setzt (beispielsweise Entwicklungen wie nanodiff-350m-typed-decisions oder rlcd-modernbert). Diese Modelle teilen das Ziel von Laya: maximale Ausführungsgeschwindigkeit, kein Text-Overhead und garantierte Typensicherheit für Pipeline-Workflows.
2. DeBERTa-v3 & ModernBERT (NLI Zero-Shot Klassifikatoren)
Der klassische Standard für Zero-Shot-Klassifikation im Open-Source-Bereich basiert auf Natural Language Inference (NLI). Modelle wie
1 | MoritzLaurer/DeBERTa-v3-base-mnli |
prüfen für jedes Label separat, ob eine Prämisse eine Hypothese stützt (Entailment).
- Vorteil: Sehr hohe Sprachpräzision für einzelne Textklassifikationen.
- Nachteil im Vergleich zu Laya: Skaliert schlecht bei vielen Klassen oder Multi-Kriterien-Abfragen, da für jedes Label eine separate Inferenz berechnet werden muss. Keine native Unterstützung für Skalen (Scores) oder parallele Typenfragen in einem Schritt.
3. GLiNER (Generalist Lightweight Information Extraction)
GLiNER ist ein extrem leistungsfähiges, bidirektionales Encodermodell, das sich auf Zero-Shot Named Entity Recognition (NER) und Informationsextraktion spezialisiert hat.
- Vorteil: Kann beliebige Entitäten (z. B. Vertragsnummern, Datumsangaben, Personen, Schadensbeträge) ohne Vortraining direkt aus dem Text ziehen.
- Einsatzbereich: Während Laya über den Zustand entscheidet (Wohin gehört das Ticket?), extrahiert GLiNER Fakten aus dem Zustand (Wie lautet die Kundennummer?). Beide Modelle ergänzen sich in Automatisierungs-Pipelines optimal.
4. SetFit (Sentence Transformer Fine-Tuning)
SetFit nutzt Sentence Transformers und kontrastives Lernen für Few-Shot-Klassifikation.
- Vorteil: Benötigt nur eine Handvoll Trainingsbeispiele (z. B. 8 bis 10 Beispieldaten pro Kategorie), um extrem treffsicher zu klassifizieren.
- Nachteil: Es handelt sich um ein Few-Shot-Verfahren mit vorgeschaltetem kurzem Training, während Laya rein deklarativ über Prompts und Kriterienkataloge ohne Retraining funktioniert.
5. Kleine generative SLMs mit Structured Decoding (Outlines, SGLang, Guidance)
Ein weiterer Ansatz ist die Nutzung kompakter generativer Modelle (Small Language Models wie Qwen 2.5 0.5B/1.5B, SmolLM2 oder Llama 3.2 1B) in Kombination mit geführter Grammatik (Constrained Decoding via Outlines oder SGLang).
- Vorteil: Kann bei Bedarf auch kurze Begründungen formulieren.
- Nachteil: Da es sich um autoregressive Modelle handelt, die Token für Token generieren, liegt die Latenz (150–500 ms) und der VRAM-Bedarf deutlich über reinen Encoder-Modellen wie Laya (~33 ms).
Systemvergleich: Die Open-Source-Ansätze für Klassifikation & Triage
Die folgende Übersicht fasst die Stärken und typischen Einsatzbereiche der wichtigsten Open-Source-Technologien zusammen:
| Technologie / Modell | Architektur & Typ | Latenz (ca.) | Multi-Fragen-Parallelität | Hardware-Bedarf | Lizenz | Bester Einsatzbereich |
|---|---|---|---|---|---|---|
| Laya (Multilingual) | Encoder (mmBERT, 322M) mit RLCD | 30 – 100 ms | Ja (in 1 Pass) | Minimal (< 2 GB VRAM / CPU) | Apache 2.0 | Ticket-Triage, Agenten-Routing, Guardrails, n8n-Workflows |
| DeBERTa-v3 NLI | Cross-Encoder (NLI Entailment) | 80 – 300 ms | Nein (sequentiell je Label) | Gering (< 3 GB VRAM) | Apache 2.0 / MIT | Klassische Dokumenten- und Sentiment-Klassifikation |
| GLiNER | Bidirektionaler Extraktions-Encoder | 50 – 150 ms | Ja (parallele Entitäten) | Gering (< 2 GB VRAM) | Apache 2.0 | Entitäten-Extraktion (IBAN, Namen, Vorgangsnummern) |
| SetFit | Bi-Encoder + Klassifikations-Kopf | 15 – 50 ms | Nein (feste Klassen) | Sehr gering (auch reine CPU) | Apache 2.0 | Feste Kategorien bei vorhandenen Beispieldaten |
| Generative SLMs (z. B. Qwen 2.5 + Outlines) | Autoregressives generatives Modell | 200 – 800 ms | Eingeschränkt (Token-Generierung) | Mittel (4 – 8 GB VRAM) | Apache 2.0 / Llama | Wenn zwingend kurze Freitextbegründungen nötig sind |
Warum Laya für datenschutzsensible Unternehmen (KMU) ideal ist
Für deutsche Unternehmen, den Mittelstand und Organisationen im KRITIS-Umfeld bietet Laya handfeste wirtschaftliche und rechtliche Vorzüge:
- 100 % DSGVO-Konformität durch On-Premise-Betrieb: Das Modell läuft vollständig auf Ihrer eigenen Firmenhardware oder in einem deutschen Rechenzentrum. Es müssen keinerlei sensible Kundendaten, Verträge oder E-Mail-Inhalte an Drittanbieter-APIs in die USA übertragen werden.
- Vielseitige Bereitstellung (CPU & GPU): Dank quantisierter Varianten (GGUF, ONNX) und nativer Unterstützung für Apple Silicon (MLX) oder mobile Systeme (CoreML) lässt sich Laya sogar auf handelsüblicher Büro-Hardware ohne teure High-End-Server-GPUs betreiben.
- Nahtlose Schnittstellen für die Entwicklungs-Praxis: Mit fertigen Integrationen für Python (
1<a class="wpil_keyword_link" title="Was ist „pip“ bei Python – Einfach erklärt" href="https://www.biteno.com/was-ist-pip/" target="_blank" rel="noopener" data-wpil-keyword-link="linked" data-wpil-monitor-id="8785">pip</a> install laya
), REST-APIs (
1laya[serve]), LangChain/LangGraph und sogar MCP-Server (
1laya[mcp]) lässt sich das System in kürzester Zeit in bestehende Workflow-Engines wie n8n oder Microservice-Architekturen einbinden.
Fazit: Pragmatische KI-Architekturen statt LLM-Monokultur
Das Laya-Modell verdeutlicht einen erfreulichen Trend in der modernen Unternehmens-IT: Weg vom Versuch, jedes Problem mit gigantischen, rechenintensiven Chat-Modellen zu lösen, hin zu zweckgebundenen, schlanken Werkzeugen.
Für dialogbasierte Beratung oder kreative Textarbeit bleiben generative Sprachmodelle unersetzlich. Doch für das automatisierte Treffen von Entscheidungen, die Steuerung interner Workflows und das Vorfiltern sensibler Daten sind spezialisierte System-1-Modelle wie Laya um ein Vielfaches schneller, günstiger und sicherer.
Sie möchten KI-Pipelines und lokale Open-Source-Modelle sicher in Ihrem Unternehmen einsetzen?
Wir bei Biteno unterstützen Sie bei der Konzeption, Absicherung und Implementierung moderner Automatisierungslösungen – von der datenschutzkonformen On-Premise-Inferenz über intelligentes Modell-Routing bis hin zur Integration in Ihre Geschäftsprozesse. Kontaktieren Sie uns unverbindlich über unser Kontaktformular – unsere Experten beraten Sie gerne.